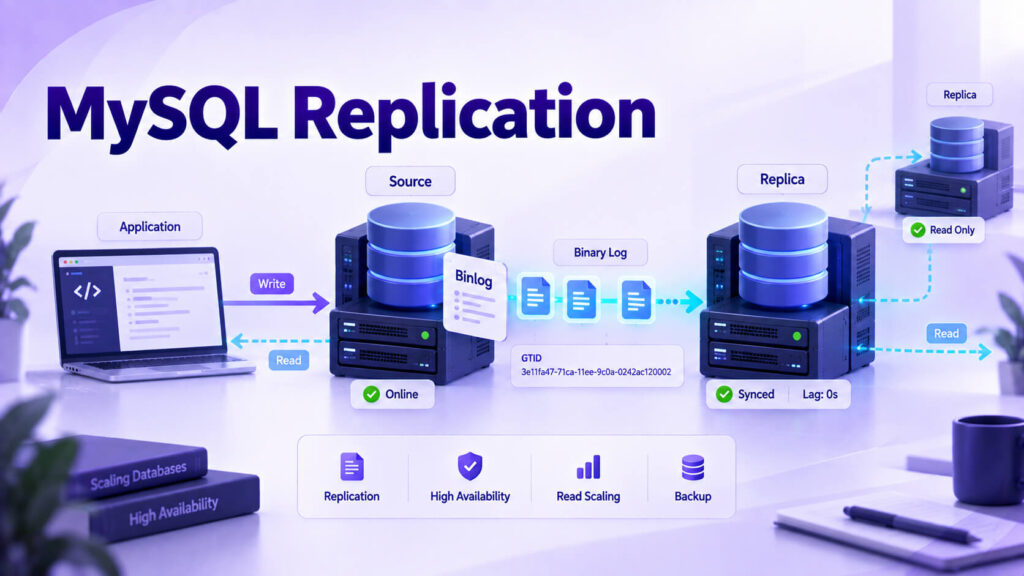
MySQL Replication یکی از مهمترین قابلیتهای MySQL برای کپی و همگامسازی داده میان چند سرور پایگاه داده است. با Replication میتوان تغییراتی که روی یک سرور اصلی انجام میشوند را به یک یا چند سرور دیگر منتقل کرد؛ قابلیتی که برای افزایش دسترسپذیری، توزیع بار خواندن، ساخت Replica برای گزارشگیری و سادهتر کردن فرایند Backup بسیار کاربردی است.
اگر عباراتی مانند MySQL Master-Slave Replication، «همگامسازی دو دیتابیس MySQL» یا «راهاندازی Replica در MySQL» را جستجو کرده باشید، در واقع درباره همین فناوری صحبت میکنیم. با این تفاوت که در نسخههای جدید MySQL اصطلاحات رسمی Source و Replica جای اصطلاحات قدیمی Master و Slave را گرفتهاند.
در این آموزش، علاوه بر توضیح اینکه MySQL Replication چیست و چگونه کار میکند، یک ساختار عملی Source → Replica را مرحلهبهمرحله راهاندازی میکنیم، Binary Log، Server ID، کاربر Replication، Snapshot اولیه، GTID، امنیت، مانیتورینگ و خطاهای رایج را بررسی میکنیم.
این راهنما بر اساس MySQL ۸.x و Syntax جدید نوشته شده است. اگر روی نسخههای قدیمی کار میکنید ممکن است همچنان دستورهایی مانند CHANGE MASTER TO، START SLAVE یا SHOW SLAVE STATUS را ببینید؛ اما برای سیستمهای جدید بهتر است از Syntax جدید Source/Replica استفاده شود.
سطح: متوسط تا پیشرفته | مناسب برای: مدیران سرور، DevOps، توسعهدهندگان Backend، مدیران دیتابیس، صاحبان VPS و مدیران زیرساخت.
فهرست مطالب
- MySQL Replication چیست؟
- Replication چگونه کار میکند؟
- کاربردهای MySQL Replication
- آیا Replication همان Backup است؟
- پیشنیازهای راهاندازی
- معماری Source و Replica
- پیکربندی Source
- تنظیم Server ID
- بررسی Binary Log
- ساخت کاربر Replication
- تنظیم Firewall و MySQL Bind Address
- ساخت Snapshot اولیه دیتابیس
- دریافت Binary Log Position
- انتقال داده به Replica
- پیکربندی Replica
- شروع Replication
- بررسی سلامت Replication
- تست عملی همگامسازی
- GTID چیست؟
- GTID یا File/Position؟
- امنسازی Replication
- Read Only کردن Replica
- Replication Lag چیست؟
- مانیتورینگ Replica
- خطاهای رایج
- آیا Replication یعنی High Availability؟
- چند Replica
- Multi-Source Replication
- بهترین روشها برای Production
- سوالات متداول
- جمعبندی
MySQL Replication چیست؟
Replication در MySQL مکانیزمی است که تغییرات یک MySQL Server را به یک یا چند MySQL Server دیگر منتقل میکند.
سروری که تغییرات اصلی روی آن انجام میشوند Source نام دارد و سرورهایی که تغییرات را دریافت و اجرا میکنند Replica هستند.
Application
     ↓
MySQL Source
     ↓
Binary Log
     ↓
MySQL Replica
در سادهترین معماری، Application تمام عملیات Write مانند:
INSERTUPDATEDELETE- تغییر Schema
را روی Source انجام میدهد و Replica این تغییرات را دریافت و تکرار میکند.
Master-Slave Replication همان Source-Replica است؟
تقریباً بله.
در بسیاری از آموزشهای قدیمی و حتی Queryهای جستجو هنوز عبارتهای زیر دیده میشوند:
MySQL Master Slave Replication
MySQL Master Master
MySQL Slave Setup
اما MySQL در مستندات جدید از اصطلاحات:
Source
Replica
استفاده میکند.
به همین دلیل در این مقاله از Source و Replica استفاده میکنیم، اما اصطلاح قدیمی را هم برای فهم آموزشها و دستورات قدیمی توضیح میدهیم.
MySQL Replication چگونه کار میکند؟
Replication کلاسیک MySQL عمدتاً بر پایه Binary Log یا Binlog عمل میکند.
فرآیند سادهشده:
1. Client تغییر ایجاد میکند
↓
2. Source Transaction را ثبت میکند
↓
3. تغییر در Binary Log نوشته میشود
↓
4. Replica Binary Log را دریافت میکند
↓
5. Replica آن را در Relay Log نگه میدارد
↓
6. Applier تغییر را روی دیتابیس Replica اعمال میکند
MySQL در معماری Replication Threadهای مستقلی برای دریافت و اعمال Eventها دارد.
در نتیجه Source لازم نیست برای اجرای هر Query منتظر Replica بماند؛ در حالت پیشفرض Replication معمولاً Asynchronous است.
کاربردهای MySQL Replication چیست؟
۱. توزیع بار Read
یکی از رایجترین کاربردها، انتقال Queryهای فقطخواندنی به Replica است.
Writes → Source

Reads → Replica 1
      → Replica 2
      → Replica 3
این معماری میتواند بار Source را کاهش دهد.
۲. ساخت Replica برای گزارشگیری
Queryهای سنگین BI و Reporting ممکن است CPU و I/O زیادی مصرف کنند.
میتوان آنها را روی Replica اجرا کرد تا Database اصلی Application کمتر تحت فشار قرار گیرد.
۳. تهیه Backup با فشار کمتر روی Source
میتوان Replica را موقتاً Pause کرد و از آن Snapshot یا Backup گرفت.
مستندات رسمی MySQL نیز Replication را بهعنوان راهی برای انتقال بار Backup از Source به Replica معرفی میکنند.
۴. Disaster Recovery
داشتن نسخهای از داده روی سرور دیگر میتواند بخشی از معماری Disaster Recovery باشد.
اما همانطور که جلوتر توضیح میدهیم، Replica بهتنهایی Backup محسوب نمیشود.
۵. نزدیک کردن دیتابیس به سرویسهای مختلف
در معماریهای بزرگ ممکن است Replicaهای مختلف برای:
- Analytics
- Reporting
- Search Indexing
- Backup
- Read API
استفاده شوند.
آیا MySQL Replication همان Backup است؟
خیر؛ این یکی از مهمترین نکات این مقاله است.
فرض کنید روی Source بهاشتباه این دستور اجرا شود:
DROP DATABASE production;اگر Replication سالم باشد، همین دستور میتواند روی Replica نیز اجرا شود.
یا اگر Application بهاشتباه هزاران Row را پاک کند، حذفها نیز Replicate میشوند.
بنابراین:
Replication از Availability و Distribution داده کمک میکند؛ Backup برای Recovery از خرابی منطقی، حذف، فساد داده یا حادثه است.
استراتژی بهتر:
Source
   ↓
Replica
   ↓
Scheduled Backup
   ↓
Off-server / Off-site Storage
برای مطالعه بیشتر میتوانید بخش بکاپ و بازیابی اطلاعات پویاسازان را ببینید.
پیشنیازهای راهاندازی MySQL Replication
در این آموزش فرض میکنیم دو Server داریم:
| Server | IP نمونه | نقش |
|---|---|---|
| db-source | 10.10.0.10 | Source |
| db-replica | 10.10.0.20 | Replica |
در Production بهتر است ارتباط بین این دو روی Private Network، VPN یا شبکه امن داخلی انجام شود.
نیاز داریم:
- MySQL روی هر دو Server نصب باشد.
- نسخهها با یکدیگر سازگار باشند.
- Replica بتواند با TCP/IP به Source وصل شود.
- پورت MySQL در مسیر مجاز باشد.
- هر Server یک
server_idمنحصربهفرد داشته باشد. - Binary Logging روی Source فعال باشد.
اگر قصد دارید این معماری را روی سرور مجازی پیاده کنید، ابتدا مقاله سرور مجازی چیست؟ را بخوانید. برای Database Server معمولاً استفاده از VPS با RAM کافی، دیسک NVMe و منابع پایدار اهمیت بیشتری از صرفاً تعداد vCPU دارد.
معماری مورد استفاده در این آموزش
                    Writes
Application ──────────────────► MySQL Source
                                   │
                                   │ Binary Log
                                   ▼
                              MySQL Replica
                                   │
                                   ▼
                         Read / Backup / Report
در محیط واقعی ممکن است چند Replica داشته باشید، اما برای یادگیری با یک Replica شروع میکنیم.
مرحله اول: پیکربندی MySQL Source
فایل تنظیمات MySQL بسته به Distribution میتواند در یکی از مسیرهای زیر باشد:
/etc/mysql/mysql.conf.d/mysqld.cnf
/etc/my.cnf
/etc/mysql/my.cnf
روی Ubuntu معمولاً:
sudo nano /etc/mysql/mysql.conf.d/mysqld.cnfتنظیم Server ID
هر Server در Replication Topology باید Server ID منحصربهفرد داشته باشد.
روی Source:
[mysqld]
server-id = 1
روی Replica بعداً:
[mysqld]
server-id = 2
MySQL اجازه میدهد Server ID مقداری مثبت و منحصربهفرد باشد. دو Server نباید ID یکسان داشته باشند.
بررسی Binary Logging
در MySQL ۸.۴ Binary Logging معمولاً بهصورت پیشفرض فعال است، اما حتماً وضعیت را بررسی کنید:
SHOW VARIABLES LIKE 'log_bin';خروجی مطلوب:
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| log_bin       | ON    |
+---------------+-------+
در صورت نیاز میتوانید Log Basename را نیز بررسی کنید:
SHOW VARIABLES LIKE 'log_bin_basename';در نصبهای خاصی که MySQL با روشهای دستی Initialize شده باشد ممکن است Binary Log غیرفعال باشد؛ در آن صورت باید آن را در Configuration فعال کنید.
فرمت Binary Log
وضعیت فرمت را بررسی کنید:
SHOW VARIABLES LIKE 'binlog_format';در بسیاری از Production Environmentها، Row-based Replication انتخاب قابل پیشبینیتری است:
[mysqld]
binlog_format = ROW
بعد از تغییر تنظیمات Startup:
sudo systemctl restart mysqlمرحله دوم: ساخت کاربر مخصوص Replication
روی Source وارد MySQL شوید:
sudo mysqlیک User اختصاصی ایجاد کنید:
CREATE USER 'repl'@'10.10.0.20'
IDENTIFIED BY 'A-VERY-STRONG-PASSWORD';
سپس Permission موردنیاز:
GRANT REPLICATION SLAVE ON *.* TO 'repl'@'10.10.0.20';با وجود نام قدیمی Privilege یعنی REPLICATION SLAVE، این همان Privilege رسمی موردنیاز Replication User در MySQL جدید است.
بهتر است این User:
- فقط از IP Replica اجازه اتصال داشته باشد.
- رمز مستقل و طولانی داشته باشد.
- دسترسیهای اضافی مانند ALL PRIVILEGES نداشته باشد.
مستندات رسمی MySQL نیز توصیه میکنند کاربر جداگانهای ایجاد شود که فقط Privilege لازم برای Replication را داشته باشد.
مرحله سوم: شبکه و Firewall
Replica باید بتواند به MySQL Source متصل شود.
پورت پیشفرض MySQL:
3306/TCPنباید آن را بدون محدودیت روی کل اینترنت باز کنید.
مثلاً با UFW:
sudo ufw allow from 10.10.0.20 to any port 3306 proto tcpبه این ترتیب فقط Replica اجازه اتصال دارد.
بررسی Bind Address
در Configuration:
bind-address = 127.0.0.1باعث میشود MySQL فقط روی Localhost گوش دهد.
اگر Source و Replica روی دو سرور متفاوتاند، باید MySQL روی IP شبکه موردنظر Listen کند.
مثلاً:
bind-address = 10.10.0.10یا بسته به معماری:
bind-address = 0.0.0.0در حالت دوم Firewall و MySQL User ACL اهمیت بسیار بیشتری پیدا میکنند.
بررسی Listening Port
sudo ss -lntp | grep 3306مرحله چهارم: گرفتن Snapshot اولیه از Source
اگر Source از قبل داده دارد، Replica باید ابتدا نسخه سازگاری از همان داده را دریافت کند.
برای دیتابیس InnoDB میتوان از mysqldump استفاده کرد.
مثلاً:
mysqldump \
  --single-transaction \
  --routines \
  --triggers \
  --events \
  --source-data=2 \
  --all-databases \
  > mysql-replication.sql
گزینه --source-data=2 موقعیت Binary Log را داخل Dump بهصورت Comment ثبت میکند.
--single-transaction برای InnoDB کمک میکند Snapshot سازگاری بدون Lock طولانی کل دیتابیس تهیه شود.
برای دیتابیسهای بزرگ، Logical Dump همیشه بهترین روش نیست و ممکن است استفاده از Physical Snapshot یا Backup Tool مناسبتر باشد.
مرحله پنجم: پیدا کردن Binary Log Position
اگر از File/Position Based Replication استفاده میکنید، باید نقطه شروع Replica را بدانید.
در Source:
SHOW BINARY LOG STATUS;بسته به نسخه ممکن است خروجی چیزی شبیه این باشد:
File: mysql-bin.000003
Position: 157
این دو مقدار را نگه دارید:
mysql-bin.000003
157
مرحله ششم: انتقال Dump به Replica
فایل را با SCP یا ابزار امن دیگری منتقل کنید:
scp mysql-replication.sql \
[email protected]:/root/
روی Replica:
mysql < /root/mysql-replication.sqlبسته به Authentication ممکن است لازم باشد:
mysql -u root -p < /root/mysql-replication.sqlمرحله هفتم: پیکربندی Replica
فایل Configuration را باز کنید:
sudo nano /etc/mysql/mysql.conf.d/mysqld.cnfحداقل:
[mysqld]
server-id = 2
سپس:
sudo systemctl restart mysqlمعرفی Source به Replica
وارد MySQL روی Replica شوید:
sudo mysqlسپس:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='10.10.0.10',
  SOURCE_USER='repl',
  SOURCE_PASSWORD='A-VERY-STRONG-PASSWORD',
  SOURCE_LOG_FILE='mysql-bin.000003',
  SOURCE_LOG_POS=157;
مقادیر Log File و Position باید دقیقاً همان مقادیر Snapshot شما باشند.
اگر caching_sha2_password استفاده میکنید
در MySQL جدید، caching_sha2_password Authentication رایج است.
اگر Replication Connection رمزگذاری نشده باشد ممکن است نیاز باشد گزینه زیر را اضافه کنید:
GET_SOURCE_PUBLIC_KEY = 1مثلاً:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='10.10.0.10',
  SOURCE_USER='repl',
  SOURCE_PASSWORD='A-VERY-STRONG-PASSWORD',
  SOURCE_LOG_FILE='mysql-bin.000003',
  SOURCE_LOG_POS=157,
  GET_SOURCE_PUBLIC_KEY=1;
راه بهتر برای Production استفاده از ارتباط TLS امن بین Source و Replica است.
مرحله هشتم: شروع Replication
START REPLICA;دستور جدید معادل:
START SLAVE;در نسخههای قدیمی است.
مرحله نهم: بررسی وضعیت Replication
SHOW REPLICA STATUS\Gچند مقدار بسیار مهم:
Replica_IO_Running: Yes
Replica_SQL_Running: Yes
هر دو باید معمولاً:
Yesباشند.
همچنین بررسی کنید:
Last_IO_Error
Last_SQL_Error
Seconds_Behind_Source
اگر Error Fieldها خالی باشند و Threadها فعال باشند، Replication احتمالاً سالم است.
مرحله دهم: تست عملی Replication
روی Source:
CREATE DATABASE replication_test;سپس:
USE replication_test;

CREATE TABLE users (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    name VARCHAR(100) NOT NULL
);

INSERT INTO users (name)
VALUES ('Pouyasazan');
روی Replica:
SELECT * FROM replication_test.users;اگر Row را مشاهده کردید:
1 | PouyasazanReplication کار میکند.
GTID چیست؟
GTID مخفف:
Global Transaction Identifierاست.
در GTID Replication، هر Transaction یک Identifier منحصربهفرد دریافت میکند.
در نتیجه بهجای اینکه Replica را با این دو مقدار مدیریت کنیم:
mysql-bin.000003
Position 157
MySQL میتواند Transactions را بر اساس GTID دنبال کند.
مزیت بزرگ:
- Failover سادهتر
- اضافه کردن Replica راحتتر
- کاهش وابستگی به File/Position
- مدیریت Topology بهتر
نمونه GTID
یک GTID از UUID Server و Sequence Number تشکیل میشود:
3E11FA47-71CA-11E1-9E33-C80AA9429562:27GTID بهتر است یا File/Position Replication؟
| ویژگی | File/Position | GTID |
|---|---|---|
| پیادهسازی مفهومی | ساده | کمی پیچیدهتر |
| Failover | دستیتر | سادهتر |
| نیاز به Log Position | بله | خیر |
| Topology بزرگ | مدیریت دشوارتر | مناسبتر |
برای آموزش مفاهیم، File/Position بسیار قابل فهم است؛ اما برای بسیاری از Deploymentهای جدید Production، GTID ارزش بررسی جدی دارد.
فعال کردن GTID
نمونه Configuration:
[mysqld]
gtid_mode = ON
enforce_gtid_consistency = ON
قبل از تغییر GTID روی سیستم Production، محدودیتها و روند Migration را دقیق بررسی کنید.
GTID Auto Position
در Replica:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='10.10.0.10',
  SOURCE_USER='repl',
  SOURCE_PASSWORD='A-VERY-STRONG-PASSWORD',
  SOURCE_AUTO_POSITION=1;
در این حالت نیازی به:
SOURCE_LOG_FILE
SOURCE_LOG_POS
ندارید.
امنسازی MySQL Replication
Replication حاوی داده واقعی Production است؛ بنابراین ارتباط Source و Replica باید مانند ارتباط حساس Database محافظت شود.
۱. MySQL را روی اینترنت عمومی باز نگذارید
ترجیح:
Private Network
VPN
WireGuard
Cloud Private VLAN
۲. User را به IP Replica محدود کنید
بهجای:
'repl'@'%'استفاده کنید:
'repl'@'10.10.0.20'۳. حداقل Privilege
GRANT REPLICATION SLAVE ON *.*و نه:
GRANT ALL PRIVILEGES۴. TLS Replication
MySQL امکان Replication روی TLS را فراهم میکند.
نمونه:
CHANGE REPLICATION SOURCE TO
  SOURCE_SSL=1;
در محیط حساس بهتر است CA و Certificate Verification نیز بهدرستی پیکربندی شوند.
آیا Replica را Read Only کنیم؟
در بیشتر معماریهای Source → Replica بهتر است Application نتواند روی Replica داده بنویسد.
میتوانید:
read_only = ON
super_read_only = ON
را در Configuration بررسی کنید.
super_read_only محدودیت قویتری ایجاد میکند و از Writeهای ناخواسته کاربران دارای Privilege بالا نیز جلوگیری میکند؛ البته Threadهای Replication همچنان میتوانند تغییرات Source را Apply کنند.
Replication Lag چیست؟
در Asynchronous Replication ممکن است Replica کمی عقبتر از Source باشد.
این فاصله را:
Replication Lagمینامیم.
علل رایج:
- Write زیاد روی Source
- Disk I/O کند روی Replica
- CPU ضعیف Replica
- Query یا Transaction بسیار بزرگ
- Network Latency
- Lock
- Replica زیر بار Read شدید
بررسی اولیه Lag
SHOW REPLICA STATUS\Gفیلد:
Seconds_Behind_Sourceمیتواند یک Signal اولیه باشد، اما برای مانیتورینگ حرفهای به تنهایی کافی نیست.
چه چیزهایی را در MySQL Replication مانیتور کنیم؟
حداقل:
- Replica IO Thread
- Replica SQL Thread
- Replication Lag
- Last IO Error
- Last SQL Error
- Disk Usage
- Binary Log Growth
- Relay Log Growth
- CPU
- Disk Latency
- Network
یک Replica که فقط «روشن» است الزاماً سالم نیست؛ ممکن است ساعتها عقب باشد.
خطاهای رایج MySQL Replication
Replica_IO_Running: No
معمولاً مشکل ارتباط Replica با Source است.
بررسی کنید:
- IP Source
- پورت ۳۳۰۶
- Firewall
- Username
- Password
- MySQL User Host
- TLS/Auth
تست اتصال از Replica
mysql \
  -h 10.10.0.10 \
  -u repl \
  -p
Replica_SQL_Running: No
یعنی Event دریافت شده ولی Apply آن روی Replica شکست خورده است.
مهمترین فیلد:
Last_SQL_Errorدلایل:
- Duplicate Key
- Row وجود ندارد
- Schema متفاوت است
- Write دستی روی Replica انجام شده
Error 1062 Duplicate Entry
یکی از دلایل رایج این است که روی Replica داده بهصورت مستقل تغییر کرده است.
بهجای Skip کردن کورکورانه Transaction، ابتدا دلیل Divergence را مشخص کنید.
Fatal error 1236
ممکن است Replica به Binary Log یا Positionای اشاره کند که دیگر روی Source وجود ندارد.
برای مثال Binary Log موردنیاز Purge شده است.
راهحل صحیح اغلب Re-seed کردن Replica از Snapshot جدید است.
Authentication Error
در MySQL جدید اگر User از caching_sha2_password استفاده کند و TLS فعال نباشد، ممکن است RSA Public Key Exchange لازم باشد.
در این حالت:
GET_SOURCE_PUBLIC_KEY=1یا Replication TLS را تنظیم کنید.
دستورهای مدیریت Replica
توقف Replication
STOP REPLICA;شروع
START REPLICA;نمایش وضعیت
SHOW REPLICA STATUS\Gفقط Thread دریافت
START REPLICA IO_THREAD;فقط Thread اعمال داده
START REPLICA SQL_THREAD;آیا MySQL Replication به معنی High Availability است؟
نه بهتنهایی.
داشتن:
Source + Replicaبه این معنی نیست که اگر Source خاموش شد Application خودکار به Replica منتقل میشود.
برای High Availability واقعی باید مواردی مانند:
- Failure Detection
- Promotion
- Traffic Routing
- Split Brain Prevention
- Automatic Failover
نیز مدیریت شوند.
راهکارهای دیگر MySQL مانند InnoDB Cluster و Group Replication برای سناریوهای پیچیدهتر HA طراحی شدهاند.
آیا میتوان چند Replica داشت؟
بله.
             ┌── Replica 1 → Web Reads
Source ──────┼── Replica 2 → Reports
             └── Replica 3 → Backup
یک Source میتواند چند Replica داشته باشد.
این معماری برای جدا کردن Workloadها بسیار مفید است.
Multi-Source Replication چیست؟
برعکس سناریوی قبلی، MySQL میتواند تغییرات چند Source را در یک Replica دریافت کند.
Source A ────┐
             ├──► Replica
Source B ────┘
MySQL برای هر Source یک Replication Channel جداگانه ایجاد میکند.
نمونه:
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='source1',
  SOURCE_USER='repl',
  SOURCE_PASSWORD='password'
FOR CHANNEL 'source_1';
و سپس:
START REPLICA FOR CHANNEL 'source_1';Multi-Source برای Consolidation و بعضی معماریهای Analytics مفید است، اما پیچیدگی بیشتری دارد.
Replication Filter چیست؟
لازم نیست همیشه تمام دیتابیسها Replicate شوند.
MySQL امکان Filter دارد:
CHANGE REPLICATION FILTER
REPLICATE_WILD_DO_TABLE = ('appdb.%');بااینحال Filtering باید با دقت طراحی شود، مخصوصاً اگر Transactionها بین چند Database ارتباط داشته باشند.
Source و Replica باید سختافزار یکسان داشته باشند؟
نه الزاماً، اما Replica باید توان Apply کردن Writeهای Source را داشته باشد.
اگر Source:
- NVMe سریع
- CPU قدرتمند
- Write Rate بالا
دارد و Replica دیسک بسیار کندی داشته باشد، Replication Lag دائماً افزایش پیدا میکند.
برای دیتابیسهای جدی، Storage Latency و RAM معمولاً از مهمترین معیارها هستند.
سرور ایران یا آلمان برای Replica؟
اگر Source و Replica برای HA و Replication سریع طراحی شدهاند، بهتر است Latency شبکه بین آنها پایین و مسیر پایدار باشد.
اما برای Disaster Recovery میتوان Replica یا Backup را در Location دیگری نگهداری کرد تا Failure مشترک دیتاسنتر هر دو نسخه را درگیر نکند.
برای پروژههایی که نیاز به MySQL Server مستقل دارند، میتوانید بسته به معماری از سرور مجازی ایران یا سرور مجازی آلمان استفاده کنید. سرویس آلمان فعلی پویاسازان از NVMe SSD و شبکه 1Gbps استفاده میکند و برای API و Web Application نیز ارائه میشود.
بهترین روشهای MySQL Replication در Production
- از GTID برای Topologyهای جدید و Failoverپذیر استفاده کنید.
- Replication User جداگانه و Least Privilege بسازید.
- پورت ۳۳۰۶ را عمومی نکنید.
- از Private Network یا VPN استفاده کنید.
- TLS بین Source و Replica را فعال کنید.
- Replica را Read Only نگه دارید.
- Replication Lag را مانیتور کنید.
- خطاهای IO و SQL Thread را Alert کنید.
- Binary Log Retention را متناسب با Recovery Time تنظیم کنید.
- Backup مستقل از Replication داشته باشید.
- Recovery را واقعاً تست کنید.
Replication و Backup را چگونه با هم ترکیب کنیم؟
یک معماری مناسب:
Production Source
       │
       ▼
Replica
       │
       ├── Daily Backup
       ├── Weekly Backup
       └── Off-site Copy
مزیت این روش این است که عملیات Backup میتواند روی Replica انجام شود و فشار کمتری به Database اصلی وارد کند.
بااینحال باید Backup را Periodically Restore Test کنید؛ Backupی که هرگز Restore نشده، تضمینشده نیست.
برای مطالعه بیشتر درباره طراحی Backup، دسته بکاپ و بازیابی اطلاعات را ببینید.
چطور Replica را برای Backup Pause کنیم؟
در سناریوهای خاص:
STOP REPLICA SQL_THREAD;میتواند Apply Thread را متوقف کند؛ سپس Backup گرفته شود و بعد:
START REPLICA SQL_THREAD;اما مدت Pause باعث افزایش Lag میشود و برای دیتابیس پرترافیک باید با برنامه انجام شود.
Checklist راهاندازی MySQL Replication
- MySQL روی Source و Replica نصب است.
- نسخهها سازگار هستند.
- Server IDها متفاوتاند.
- Binary Log فعال است.
- Replica به Source دسترسی TCP دارد.
- Replication User ساخته شده است.
- User فقط Privilege لازم را دارد.
- Firewall فقط Replica را مجاز میکند.
- Snapshot اولیه Consistent است.
- Binlog Coordinates یا GTID صحیح است.
- IO Thread فعال است.
- SQL Thread فعال است.
- Lag مانیتور میشود.
- Replica Read Only است.
- Backup مستقل وجود دارد.
سوالات متداول درباره MySQL Replication
MySQL Replication چیست؟
فرآیندی است که تغییرات یک MySQL Server یا Source را با استفاده از Binary Log به یک یا چند Replica منتقل میکند.
Master-Slave در MySQL چیست؟
نام قدیمی معماری Source-Replica است. در MySQL جدید اصطلاح Source بهجای Master و Replica بهجای Slave استفاده میشود.
آیا MySQL Replication رایگان است؟
قابلیتهای استاندارد Replication بخشی از MySQL Server هستند، اما نوع Distribution و ابزارهای Enterprise جانبی میتوانند شرایط لایسنس جداگانه داشته باشند.
آیا Replication Real-Time است؟
Replication معمولاً بسیار سریع است، اما Asynchronous Replication تضمین نمیکند Replica در همان لحظه دقیقاً با Source همگام باشد. ممکن است Lag وجود داشته باشد.
Replication Lag چیست؟
فاصله زمانی میان Transaction اعمالشده روی Source و اعمال همان Transaction روی Replica است.
چطور بفهمیم Replication سالم است؟
SHOW REPLICA STATUS\Gرا اجرا کنید و حداقل وضعیت IO Thread، SQL Thread، Errorها و Lag را بررسی کنید.
آیا Replication جایگزین Backup است؟
خیر. تغییر یا حذف اشتباه داده نیز میتواند به Replica منتقل شود. Backup مستقل و قابل Restore ضروری است.
GTID چیست؟
شناسه جهانی و منحصربهفرد Transaction است که مدیریت Replication و Failover را سادهتر میکند.
GTID بهتر است یا Binlog Position؟
File/Position برای یادگیری و Topology ساده مناسب است؛ GTID در بسیاری از معماریهای جدید مدیریت Failover و تغییر Source را سادهتر میکند.
آیا میتوان فقط یک دیتابیس را Replicate کرد؟
بله، MySQL Replication Filter ارائه میکند؛ اما باید Dependency و Transactionهای بین Databaseها را نیز در طراحی در نظر بگیرید.
آیا Replica میتواند Query دریافت کند؟
بله. یکی از کاربردهای رایج Replica اجرای Read Query، Reporting یا Backup است.
آیا باید روی Replica Write انجام دهیم؟
در معماری معمول Source → Replica بهتر است خیر؛ Write مستقل میتواند باعث Data Divergence و خطاهای Replication شود.
آیا Source و Replica میتوانند در دو کشور متفاوت باشند؟
بله؛ ولی Network Latency، Packet Loss و Reliability روی Replication تأثیر میگذارند. برای HA سریع معمولاً فاصله کمتر مزیت دارد، اما برای Disaster Recovery جدایی جغرافیایی میتواند مفید باشد.
چند Replica میتوان به یک Source متصل کرد؟
MySQL امکان چند Replica را دارد؛ محدودیت عملی به ظرفیت Source، Network، Binlog Traffic و معماری بستگی دارد.
آیا MySQL Replication خودکار Failover انجام میدهد؟
Replication ساده بهتنهایی Failover کامل ایجاد نمیکند. برای Automatic Failover باید Detection، Promotion و Traffic Routing نیز طراحی شود.
جمعبندی
MySQL Replication یکی از مهمترین ابزارهای ساخت زیرساخت دیتابیس مقیاسپذیر و مقاومتر است. در سادهترین حالت، Source تغییرات را در Binary Log ثبت میکند و Replica آن تغییرات را دریافت و Apply میکند.
برای یک Setup ساده میتوان از File/Position Based Replication استفاده کرد، اما برای معماریهای جدید و سناریوهایی که Failover، چند Replica یا تغییر Source اهمیت دارد، GTID میتواند مدیریت سیستم را سادهتر کند.
همچنین سه اصل را فراموش نکنید:
- Replication را Backup فرض نکنید.
- Replica را مانیتور کنید؛ صرف روشن بودن آن کافی نیست.
- ارتباط MySQL را روی شبکه عمومی بدون محدودیت باز نگذارید.
اگر برای Source و Replica نیاز به سرور مستقل دارید، بخش سرورهای مجازی و اختصاصی پویاسازان را بررسی کنید. برای پروژههایی با کاربران داخل ایران، سرور مجازی ایران و برای سرویسهای بینالمللی یا زیرساخت اروپا، سرور مجازی آلمان قابل بررسی هستند.
همچنین مقالات تخصصی مرتبط با MySQL و Storage در دسته دیتابیس و ذخیرهسازی منتشر میشوند.